Mit tehet a gépi tanulás az emberi tanulásért? Egy közös projektben a Digitális Pedagógiai Módszertani Központ, a Microsoft és a Dmlab arra kereste a választ, hogyan segítheti az adatelemzés a korai iskolaelhagyás elleni munkát. A válasz három szinten született meg: mi történt, miért történt, és mi fog történni.
A projekt adatai egy helyen
| |
|---|
| Terület | Közoktatás, korai iskolaelhagyás |
| Partnerek | DPMK (domain tudás), Microsoft (technológia), Dmlab (adatelemzés) |
| Adatforrások | Intézményi és tanári adatok, országos kompetenciamérés, PISA, Kréta rendszer |
| Technológia | Azure, Power BI |
| Megoldási szintek | Leíró elemzés és dashboard, összefüggés-feltárás, előrejelzés |
| Kiemelt eredmény | 92 százalékos pontosságú előrejelzés a rejtett kockázatú intézményekre |
Miért probléma a korai iskolaelhagyás?
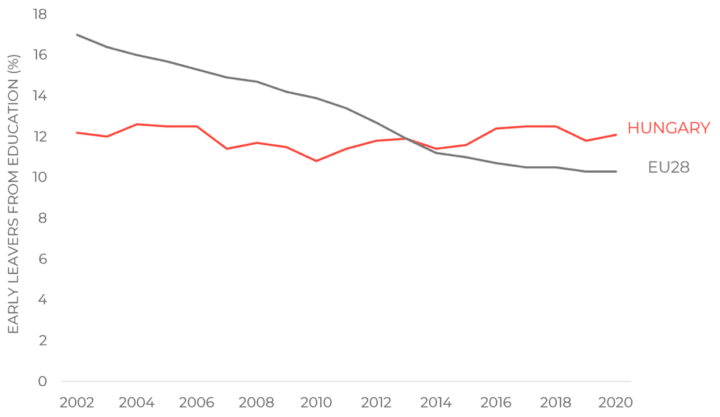
Korai iskolaelhagyónak azt a 18 és 24 év közötti fiatalt nevezzük, aki legfeljebb általános iskolai végzettséggel rendelkezik. Magyarországon ez az arány nagyjából 12 százalék, ami évente körülbelül 80 ezer fiatalt jelent.
Érdemes ezt a számot egy másik mellé tenni: évente körülbelül 50 ezer magyar fiatal szerez felsőfokú diplomát, miközben 80 ezren maradnak középfokú végzettség nélkül. Az Európa 2020 stratégia célja 10 százalék, és amíg európai szinten 2002 és 2019 között összességében 7 százalékpontos csökkenés történt, Magyarországon a mutató lényegében stagnál.
A probléma tehát mérhető, nagy volumenű, és több évtizedes hatása van az érintettek életére. Pont az a fajta kérdés, ahol az adat nem önmagáért érdekes, hanem azért, mert a beavatkozás helyét és idejét segít megtalálni.
Három szint, három kérdés
A projektben nem egyetlen megoldást építettünk, hanem három, egymásra épülő referenciamegoldást. Ez a felosztás megfelel annak, ahogyan a data science projektek négy típusa épül egymásra: előbb látni kell, mi történik, aztán megérteni, miért, és csak ezután érdemes előrejelezni.
| Szint | A kérdés | A megoldás | Mire használható |
|---|
| Leíró | Mi történt? | Integrált adatkép és dashboard | Intézmények összehasonlítása, kiugró esetek felismerése |
| Diagnosztikus | Miért történt? | Automatikus összefüggés-feltárás | A kockázatot hordozó intézményi jellemzők azonosítása |
| Prediktív | Mi fog történni? | Előrejelző modell | A rejtett kockázatú intézmények kiszűrése beavatkozás előtt |
Mi történt? Egységes adatkép és dashboard
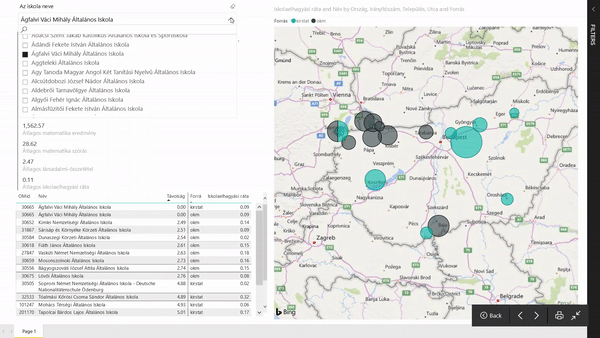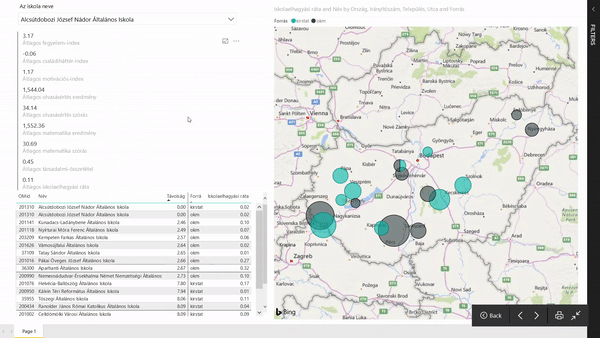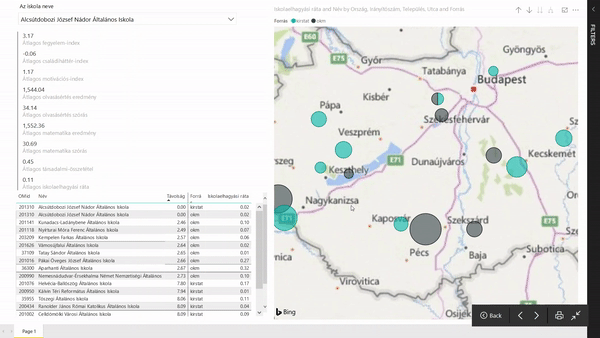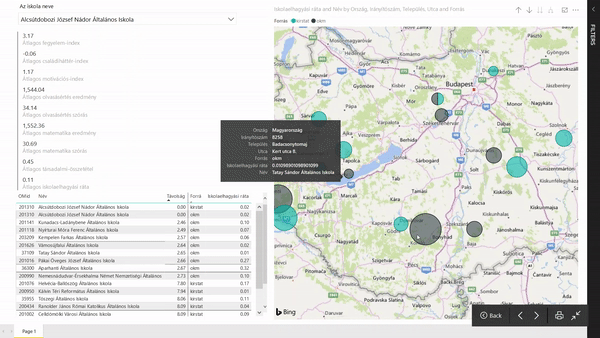
Az első szint önmagában is meglepően sokat ad, pedig technológiailag ez a legegyszerűbb. Az oktatási adatok több helyen, több rendszerben keletkeznek: intézményi, tanári és tanulói szinten egyaránt. Az egységes adatkép és dashboard lényege, hogy ezek egy nézőpontból legyenek vizsgálhatók, vagyis megszülessen az az egyetlen közös igazságforrás, amire a szakmai vita építhet.
A legfontosabb megfigyelés ezen a szinten az volt, hogy egymáshoz hasonló intézmények között jelentős eltérések mutatkoznak a lemorzsolódás arányában, és ezek az eltérések nem magyarázhatók a földrajzi közelséggel. Ez a felismerés önmagában is irányt ad: ha két hasonló iskola eredménye nagyon eltér, akkor van mit tanulni az egyiktől.
Miért történt? Rejtett összefüggések feltárása
A második szinten automatikus tulajdonságfelismeréssel kerestük azokat az intézményi részcsoportokat, amelyeken belül más összefüggések érvényesülnek, mint a teljes halmazon. A módszer több mint tízezer lehetséges jellemző közül választja ki azokat, amelyek valóban elkülönítenek egy csoportot, tehát nem előzetes hipotéziseket ellenőriz, hanem maga keresi meg a mintázatot.
Az egyik legbeszédesebb eredmény egy olyan intézménycsoportnál jött ki, ahol vegyes az etnikai összetétel és magas az évfolyamismétlők aránya. Ebben a csoportban azokban az iskolákban, ahol nem volt iskolatitkár, a lemorzsolódási arány 57 százalék volt, ahol pedig volt, 36 százalék.
A különbség nagy, és éppen ezért kell vele óvatosan bánni. Az összefüggés nem jelent ok-okozati kapcsolatot: nem az iskolatitkár alkalmazása csökkenti a lemorzsolódást, sokkal inkább arról lehet szó, hogy az iskolatitkár megléte olyan szervezeti és adminisztratív kapacitás jele, amely más módon hat. Az ilyen eredmény nem intézkedés, hanem nyom: megmutatja, hol érdemes a szakértőnek tovább vizsgálódnia. Ez a szakasz az, ahol az adatelemzés és a domain szakértő munkája elválaszthatatlan.
Mi fog történni? Előrejelzés
A harmadik szinten azt vizsgáltuk, mennyire jelezhető előre a lemorzsolódás. Két eredmény született.
Az egyik, hogy az országos kompetenciamérés intézményi átlagai és szórásai előrejelezhetők a korábbi kompetenciamérési és iskolai statisztikai adatokból.
A másik, és gyakorlati szempontból ez az érdekesebb, azokra az intézményekre vonatkozik, ahol a kompetenciamérés alapján nem várható magas lemorzsolódás, mégis bekövetkezik. Ezek a rejtett kockázatú iskolák, amelyek egy hagyományos szűrésen átcsúsznak. További intézményi jellemzők bevonásával ezek az esetek 92 százalékos pontossággal előrejelezhetők.
Ez az a pont, ahol az elemzésből döntéstámogatás lesz: nem egy általános kockázati rangsor készül, hanem azoknak az intézményeknek a listája, amelyekre senki nem figyelne oda magától.
Mire képes ez nagyban? Egy nemzetközi példa
Hogy a hasonló megközelítés milyen léptékű hatást tud elérni, arra jó példa a Microsoft Tacoma körzetben megvalósult prediktív megoldása. Ott a program bevezetése előtt a diákok 55 százaléka fejezte be sikeresen a középiskolát, utána 83 százaléka.
Ez nem egy modell érdeme önmagában. A szám azt mutatja meg, mi történik akkor, ha az előrejelzés beépül a mindennapi működésbe, tehát ha van, aki a jelzés alapján cselekszik is.
Milyen adatokra lehet ezt Magyarországon építeni?
A projekt egyik mellékeredménye a magyar adatvagyon feltérképezése volt. Négy forráscsoport bizonyult használhatónak:
- Intézményi adatok: épületek, infrastruktúra, működési jellemzők.
- Tanári adatok: végzettségek, elvégzett képzések, munkaterhelés.
- Tanulói kompetenciák: az országos kompetenciamérés és a PISA teszt eredményei.
- Kréta rendszer: a diákok mindennapi iskolai viselkedéséről szóló adatok.
A legnagyobb érték abban van, hogy ezek együtt nézhetők. Külön-külön mindegyik ismert, a kérdésre viszont csak összekapcsolva adnak választ.
Kinek mi volt a szerepe?
A projekt három szereplő együttműködésére épült, és mindegyik mást hozott. A DPMK a domain tudást, a Microsoft a technológiát, az Azure és a Power BI képességeit, a Dmlab pedig az adatelemzési szakértelmet.
Horváth Ádám, a DPMK divízióvezetője így foglalta össze: "olyan szakmai megállapítások születtek a közös projekt során, melyekre hagyományos adatelemzési eszközökkel esély sem lett volna."
Ez a felosztás nem véletlen. Egy közszférás adatprojekt akkor hoz eredményt, ha a szakmai kérdést az érti, aki a területen dolgozik, az adatot pedig az, aki elemzi, és a kettő nem egymás után, hanem egyszerre van jelen.
Mit jelent ez egy másik szervezetnek?
Három tanulság vihető át bármilyen területre.
- Több szinten érdemes keresni a hasznosítást. Még egy jól körülhatárolt problémánál is igaz, hogy a leíró elemzés, az összefüggés-feltárás és az előrejelzés mást ad. Aki rögtön a predikcióval kezd, gyakran kihagyja azt a felismerést, ami a legolcsóbban a legtöbbet hozta volna.
- Az eredmény a szakértővel együtt értelmezhető. Az adatelemző megtalálja a mintázatot, de azt, hogy az mit jelent, és mi kezdhető vele, csak a terület ismerőjével közösen lehet eldönteni.
- Az összefüggés nem ok-okozat. Ez nem elméleti figyelmeztetés. Egy közszférás döntésnél a rosszul értelmezett korreláció valódi intézkedéssé válhat, ezért a modellnek nemcsak pontosnak, hanem értelmezhetőnek is kell lennie.
Ugyanez a logika működik más iparágakban is, ahogy az esettanulmányaink mutatják. Minél nagyobb folyamat lesz adatvezéreltté, annál nagyobb az üzleti és társadalmi hatás.
Gyakori kérdések
Kit nevezünk korai iskolaelhagyónak?
Azt a 18 és 24 év közötti fiatalt, aki legfeljebb általános iskolai végzettséggel rendelkezik. Magyarországon ez az arány nagyjából 12 százalék, ami évente körülbelül 80 ezer fiatalt jelent.
Mennyire pontosan jelezhető előre a lemorzsolódás?
A projektben azoknál az intézményeknél, ahol a kompetenciamérés alapján nem várható magas lemorzsolódás, mégis bekövetkezik, 92 százalékos pontosságú előrejelzést sikerült elérni további intézményi jellemzők bevonásával.
Az előrejelzés diákokat vagy intézményeket rangsorol?
Ebben a projektben intézményi szinten dolgoztunk. Ennek adatvédelmi és szakmai oka is van: intézményi szinten a beavatkozás is szervezeti, és nem keletkezik egyéni szintű kockázati bélyeg.
Kell hozzá új adatgyűjtés?
Nem feltétlenül. A projekt a meglévő forrásokra épült: intézményi és tanári adatokra, a kompetenciamérésre, a PISA eredményekre és a Kréta rendszerre. A munka nagy része nem az adat beszerzése, hanem az összekapcsolása és értelmezése volt.
Átvihető ez más közszférás területre?
A szerkezet igen. A leíró, diagnosztikus és prediktív szintek egymásra építése, a domain szakértővel való közös értelmezés és a kauzalitás óvatos kezelése ugyanúgy érvényes az egészségügyben, a szociális ellátásban vagy a foglalkoztatáspolitikában.